
Det är bättre att experimentera med modeller på ett grafikkort.
Det är bättre att experimentera med modeller på ett grafikkort.
Forskare från OpenAI har publicerat en vetenskaplig artikel som beskriver det neurala nätverket GLIDE. Dess uppgift är att generera fotorealistiska bilder genom textbeskrivning och redigera dem – även genom beskrivning.
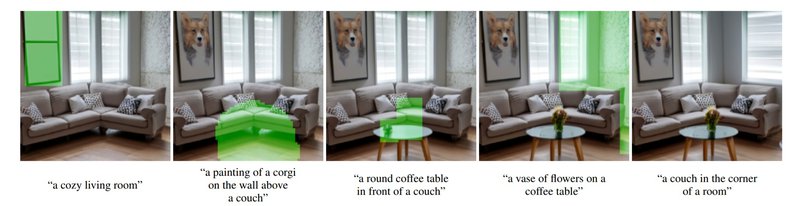
Det neurala nätverket kan känna igen mer eller mindre naturligt språk. Som ett exempel nämner forskarna följande kommandosekvens: “mysigt vardagsrum”, “porträtt av en corgi på väggen ovanför soffan”, “rundt soffbord framför soffan.”
Det första kommandot genererar bilden, de efterföljande är ansvariga för att redigera den. Ett porträtt och en tabell visas på bilden; men då beslutar det neurala nätverket, utan ett kommando, att ändra arrangemanget av fönstren.
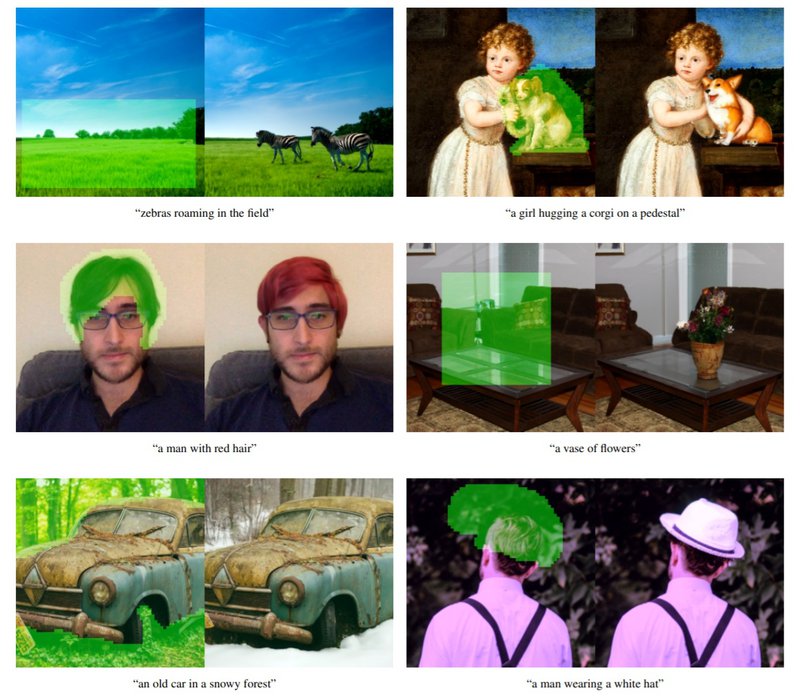
Det neurala nätverket hanterar också riktiga bilder. I exemplen nedan tar AI ett foto och redigerar det sedan med enkla textinstruktioner på naturligt språk.
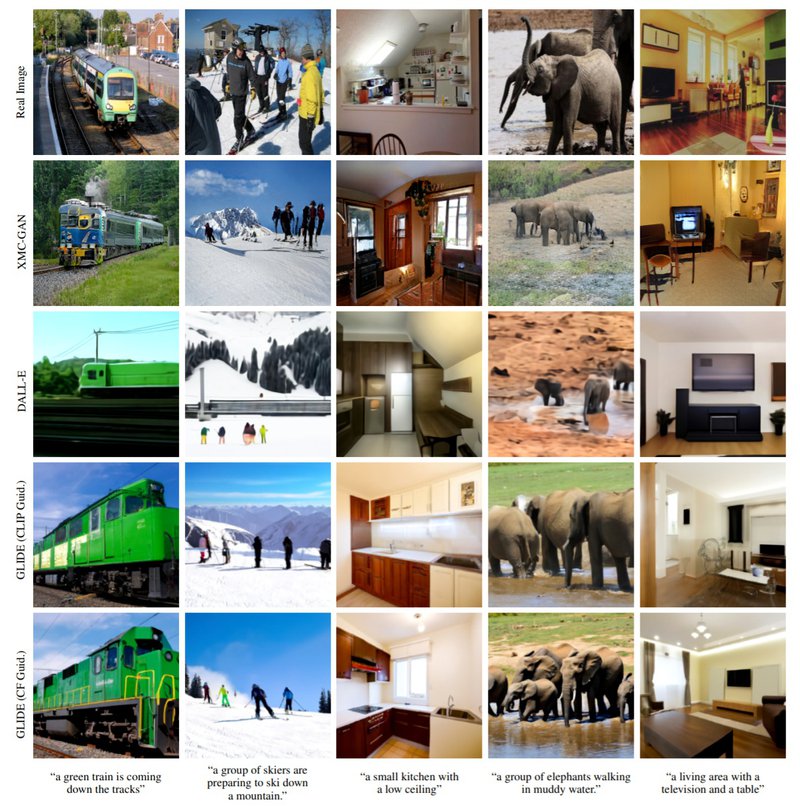
GLIDE är inte det första neurala nätverket som kan generera bilder från beskrivningar, men OpenAI är övertygad om att deras utveckling klarar denna uppgift bättre än konkurrerande AI:er. Här är en jämförelse av de två GLIDE-versionerna med DALL-E, XMC-GAN och riktiga foton.
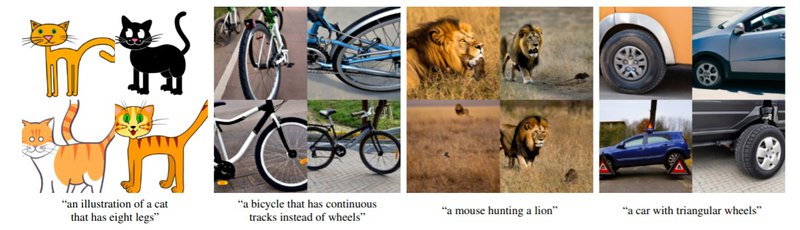
Ett neuralt nätverk kan dock inte alltid uppfylla uppgiften. GLIDE hanterar ovanliga frågor dåligt: tydligen eftersom bilderna som används för att träna modellen inte har så många bilar med triangulära hjul eller möss som jagar lejon.
Vem som helst kan experimentera med det neurala nätverket. Forskarna släppte källkoden och en modell med 300 miljoner parametrar till allmänheten. Alla bilder i denna text har genererats av en modell med 3,5 miljarder parametrar.
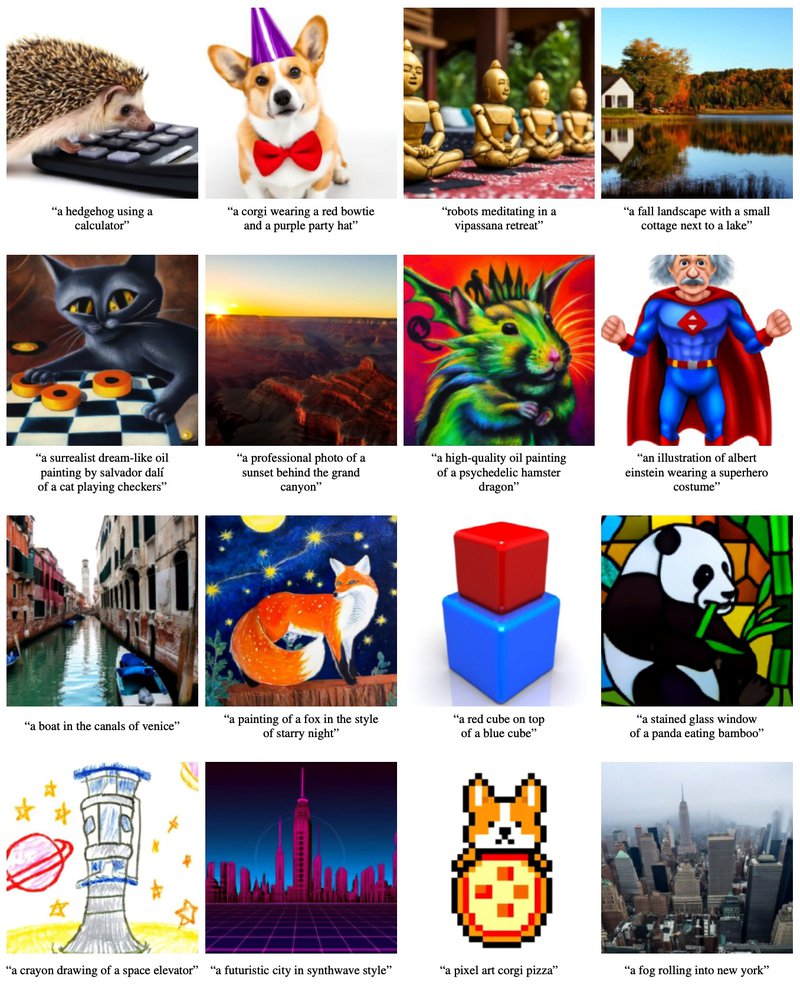
Det är sant att experiment bör utföras på ett grafikkort. Att generera en bild på CPU, räknade entusiaster, kan det ta cirka 20 minuter, och grafikkortet kan göra det på ungefär en minut.
Minecraft bygger en glitchfarm som producerar en miljon föremål per timme

